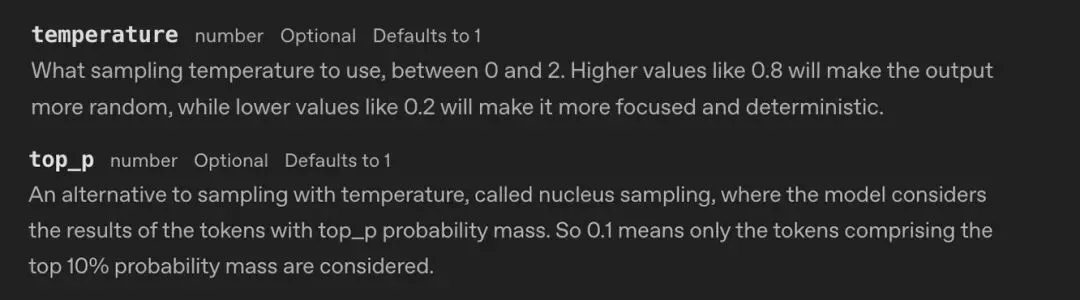
在AI时代,大语言模型(LLM)如 ChatGPT 或Gemini 已成为我们的“数字大脑”。如果你经常使用这些大模型,那你肯定见过Temperature 和 TopP 这两个参数。比如 ChatGPT 的API文档就有介绍:
testfather.cn
根据描述:
-
Temperature(温度): 取值在 0 到 2 之间。较高的值(如 0.8)将使输出更加随机,而较低的值(如 0.2)将使输出更加集中和确定。
-
Top P(核采样) :温度采样的替代方法。模型仅考虑概率质量排名前 P% 的标记的结果。例如,0.1 表示仅考虑概率排名前 10% 的标记。
看到这里,你可能觉得已经懂了:它们就是控制随机性的开关嘛。值越高越发散,值越低越保守。
但仔细一想,问题来了:
-
为什么同样一个问题,AI 有时回答得很保守,有时却明显更发散?
-
为什么值越高越随机,越低越稳定?
-
如果它们控制的都是随机性,为什么需要两个参数?
-
如果把一个调高,另一个调低,效果会中和吗?
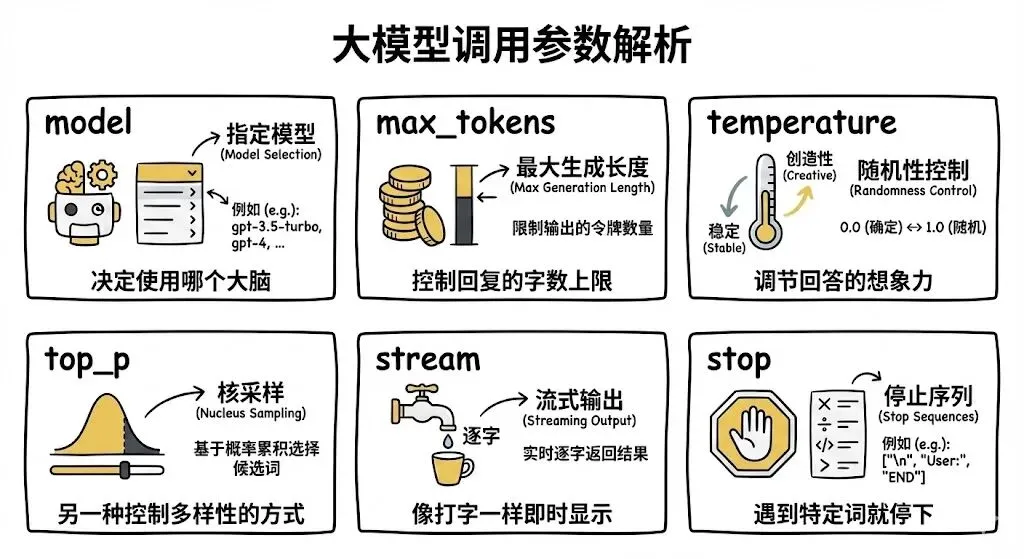
带着这些问题,我们来尝试拆解一下大模型中最容易影响输出质量的几个参数:temperature、top-k、top-p。
testfather.cn
1. 大模型是如何回答问题的?
在深入了解这些参数之前,我们先要知道 AI 是怎么回答问题的,在前面内容学习中,相信你已经知道了,大模型是如何预测下一个字的。
大模型的输出,本质上是根据提示词来预测下一个词出现的概率,更准确地说,是根据上文,预测下一个最有可能出现的词(Token),重复此过程直到生成结束符。
想象一下,AI 就像一个你的超级博学的好朋友,每次你问它问题,它脑子里都会冒出很多种可能的回答。比如你问"今天天气怎么样?",它可能想到~
- "今天天气很好"(概率 40%)
- "今天阳光明媚"(概率 30%)
- "今天万里无云"(概率 15%)
- "今天适合出游"(概率 10%)
- "今天紫外线很强"(概率 5%)
AI 会根据这些概率来决定最终说什么,而我们今天要讲的几个参数,就是用来调整这个"决策过程"的。
假设我们的提示词是:
Twinkle twinkle little
此时,大模型会根据已有的提示词,生成一个“下一个词”的概率表。下图是一个 0~100 的坐标轴,把这些被预测的词按照概率大小放在这个坐标轴上。概率越高,占据的区间就越大。
testfather.cn
接下来,大模型会基于这个概率分布进行一次随机采样。你可以把这个过程想象成生成了一个随机数。这个随机数落在哪个区间,就输出对应区间的那个词。
我们可以看到,star 这个词出现的概率是最高的,因此大模型输出的结果有很大的概率是:
Twinkle twinkle little star
上述的这个过程可以拆解为三个关键步骤:生成分数 (Logits) --> 转换概率 (Softmax) -->加权采样 (Sampling)。
testfather.cn
步骤1: 生成分数(Logits)
我们用一个简单例子说明:当用户提问“帮我推荐一个学习 AI 大模型技术的频道”时,模型会扫描它词表里成千上万个词,并为每一个词打分。这个分数在 AI 领域被称为 Logits。
假设模型打分后,排名前五的词如下:
- AI:4.2
- 科技:4.1
- 奇舞:3.9
- 自行车:1.8
- Hello:1.4
打分过程比较复杂,好在跟我们今天的内容关系不大,我们可以暂且忽略。
在大型语言模型(LLM)完成对所有词汇的评分后,下一步的关键在于如何从这些分数中选择最合适的词作为输出。一种直观且常用的方法是选择得分最高的词。
例如,假设模型在预测序列中的下一个词时,对词汇表中的每个词都进行了评分,比如上面例子中的 "AI" 这个词获得了最高分。那么,模型会选择 "AI" 作为当前步骤的输出。
接下来,模型会将 "AI" 这个词添加到输入序列中,并再次进行下一个词的预测。这意味着模型会重新评估词汇表中的每个词,并为它们分配新的分数。同样,模型会选择得分最高的词作为下一个输出。
这个过程会不断重复,模型逐个输出每一个词,并将每个新生成的词添加到输入序列中,以影响后续词的预测。这种迭代式的生成过程会持续进行,直到模型输出一个特殊的结束标识符(例如 "")为止。结束标识符的出现标志着文本生成的完成。
【原文图片暂缺】
虽然选择得分最高的词是一种简单直接的解码策略,但它也存在一些局限性:
- 缺乏多样性: 这种策略倾向于选择最常见的词,导致生成的文本缺乏多样性和创造性。模型可能会陷入重复的模式,生成平淡无奇的内容。
- 对噪声敏感: 如果模型在某个步骤中给出了错误的高分,那么这个错误可能会被放大,导致后续生成的文本偏离预期。
- 忽略上下文: 虽然模型会将之前生成的词作为输入,但简单地选择最高分可能会忽略更长远的上下文信息,导致生成的文本不连贯或不自然。
这样简单的选择分数最高的词显然是不合适的,我们需要给其他词,比如“科技”或“奇舞”一定机会。聪明的你肯定想到了,把这些词的分数转为概率,让模型按照概率来预测下一个词。提到转换概率,这就轮到大名鼎鼎的 Softmax 函数 登场了。
步骤2: 转换概率(Softmax函数)
Softmax函数就相点复杂了,这里就不扩展讲了,简单来说,Softmax函数会保证所有词的概率相加为100%。
testfather.cn
步骤3:加权采样 (Sampling)
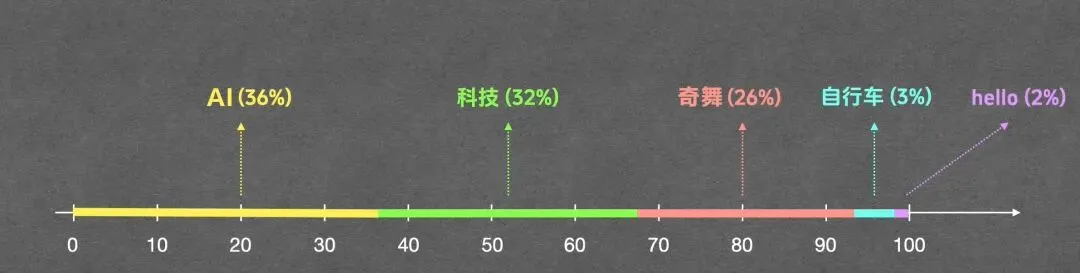
得到了每个词的概率后,就需要根据概率来生成下一个预测的值。一般称这个通过概率来生成预测值的过程为: 加权采样。可以用一个从0到100这个区间的横轴来举例。
”AI“这个词的概率为36%,那么在横轴上给它分配0到36这段区间,科技的概率是32%,我们就给它分配随后的长度为32的这段区间,以此类推。
testfather.cn
然后生成一个0到100的随机数。比如说随机数是8,落到了这个[0,36]这个区间,我们就选择 AI。这个就叫做给每个词分配与概率相等的机会。这意味着,虽然“AI”概率最高,但模型也有机会选择“科技”或“奇舞”。这种机制保证了回答的合理性,同时赋予了 AI 创造力和变化。
在理解了这个基本原理之后,下面我们来看几个具体参数是如何影响大模型“选词过程”的。
2、影响大模型输出常用参数
2.1 Temperature (温度)
Temperature(温度)是控制 AI 回答生成文本随机性和创意性的参数,它控制的是“贫富差距”,低 T 拉大差距,高 T 缩小差距。取值范围通常是 0 到 2。
本质上来说,Temperature 是通过调整候选答案的概率分布来工作的
testfather.cn
我们以上述提示词为例:
复制代码
Twinkle twinkle little
当 Temperature 的值被调低时,各个候选词之间的概率差距会被放大,原本概率高的词被选中的可能性也就更高,大模型输出的结果会更加稳定。原本 star 与 car 的概率差距约为 19.6;而当 Temperature 被降低到 0.5 时,这个差距明显增大,在当前示例中达到了 36.1。
testfather.cn
与之相反,当 Temperature 的值被调高时,各个候选词之间的概率差距会缩小,一些原本概率较低的词也更容易被选中,大模型输出的结果会更加随机。下图是 Temperature 被增加到 1.68 时,各个候选词之间的概率差距。
testfather.cn
需要注意的是,Temperature 并不会改变“有哪些词是可能的”,而是改变这些词之间的概率差距。如果没有 Temperature,大模型就是一台只会背书的复读机。
Temperature(温度)概率选取建议:
- 低温(0.1-0.5):当 T 很小时(如 0.1),分数被放大,高分词的优势被无限拔高,低分词的概率被压缩至近乎为 0。模型几乎只选第一名,输出极度稳定、保守,只偏爱那几个最高概率的词,适用于代码生成、事实性问答、摘要生成、需要高度准确性和连贯性的场景、技术文档编写,避免模型“胡言乱语”,但输出结果也可能会乏味、重复。
- 中温(0.7-1.0):模型保持原始的预测概率分布,不做任何修改,适用于大多数通用场景。(大多数的大模型Temperature 通常默认值是 0.7 或 1.0)
- 高温(接近 2):当 T 很大时(如 2.0),分数被缩小。差异被拉平,指数运算后的结果差别不大。概率分布变得平缓。高分词优势不再明显,长尾词(不太可能但也可行)的词也有了被选中的机会,讲究的是众生平等,结果输出会更加随机、多样、有创意,甚至可能跑题、荒谬、出现小错误。适用于创意写作(诗歌、故事、歌词)、头脑风暴、生成多样化答案、增加趣味性。
temperature 参数值建议:
-
创意写作:使用较高值(0.7-1.0)以增加多样性
-
问答系统:使用较低值(0.2-0.5)以确保准确性
-
代码生成:使用极低值(0.1-0.3)以保持逻辑一致性
-
默认推荐:0.7 是平衡创造性和准确性的良好起点
参数小结
“温度参数就像给模型的‘想象力’拧开关。温度高,模型放飞自我,天马行空;温度低,模型一本正经,只讲最保险的‘标准答案’。写科幻小说调高点,写法律合同调低点。”
总结一句话:“想让模型严谨就调低,想让模型有创造力就调高。”
2.2 Top-k (采样数)
Top-k 采样参数是用来控制参与选择的候选词数量,即划定“候选词”的范围。
当 Top-k 等于 1 时,大模型只会考虑概率最高的那个词,因此输出结果会变得非常确定。
testfather.cn
当 Top-k 等于 5 时,大模型会从概率最高的前 5 个词中选择一个词作为最终结果,其余词不会被考虑。
testfather.cn
形象比喻
考试结束后,老师只看前 K 名高分学生的卷子,然后根据他们的分数高低(对应概率大小),随机抽一个学生作为“标准答案”,Top-k 就是设定这个 K 值。
-
K 小 (如设为3、5、10):只看最顶尖的几个“学霸”(高概率词),从他们中选。输出更安全、更集中、更可预测,但也可能错过一些潜在的、有趣的“偏科天才”(中低概率但有意义的词)。
-
K 大 (如设为30、50、100):允许更多“中等生”(中低概率词)进入候选池。输出更丰富、更多样化、更有惊喜,但也可能抽到一些“学渣”(极低概率的、不靠谱的词)导致输出质量不稳定。
技术本质
- 模型计算出所有词的概率分布。
- 只保留概率最高的前 k 个词。
- 将这 k 个词的原始概率重新归一化(确保它们的概率和为 1)。
- 从这个新的归一化后的概率分布中随机抽取下一个词。
优势:比纯随机采样(在整个词表上采样)更高效,可以避免选择那些极其不可能的单词,提供了一定的可控性。
劣势:
- 如果 k 太小,会排除掉许多合理的、能丰富文本的中等概率词。
- 如果 k 太大,可能让极低概率词混入,导致不连贯或无意义的输出。
- 对分布形状敏感:有些文本上下文中,高概率词就那么5-6个;有些则可能前20个词概率差异不大。固定 k 可能在不同上下文中带来不一致的多样性。这在长文本生成时可能尤其明显。
使用场景
- 小 k (10-20): 需要高确定性、高连贯性的任务。适合短文本生成。
- 中等 k (40-100): 平衡多样性和质量的通用场景。
- 不推荐非常大 k (接近词表大小): 基本退化回纯随机采样,失去控制意义。
- 有时会与 temperature 联用: 先用 temperature 调整原始分布,再用 top-k 过滤。
参数小结:
“Top-k 是模型选词时的‘只看班级前几名’规则。K值小,模型‘势利眼’,只认学霸;K值大,模型‘有教无类’,但也可能抓个捣蛋鬼出来。关键是让模型在该‘靠谱’的时候靠谱,该‘出格’的时候有出格的机会。”
2.3 Top-p (核采样)
Top-p(也叫 nucleus sampling,核采样)全称为:Top Cumulative Probability(最高累加概率),P指的就是一个概率阈值。模型从高分词开始往下累加概率,一旦累加值超过 P,后面的词全部切掉。
该参数决定 了AI 从多大的候选答案池中选择,取值范围是 0 到 1,按概率累积。
模型会从概率最高的词开始,逐个向下累加,当累计概率达到 Top_p 所设定的值时,就只保留这些词作为候选,其余词会被过滤掉。
例如,当 Top_p = 0.6 时,模型只会在“累计概率已经达到 60%”的那一部分词中进行选择。
testfather.cn
随后,这些被保留下来的词会被重新归一化,保证整体概率仍然是 100%。
testfather.cn
因此,Top_p 控制的是“概率覆盖范围”,而不是候选词的数量。
想象你在自助餐厅选菜
- Top-p = 1.0:整个餐厅所有菜都可以选,从招牌菜到冷门小菜
- Top-p = 0.9:只看最受欢迎的那些菜,直到它们的"受欢迎度"加起来达到 90%
- Top-p = 0.5:只从最热门的几道菜里选,其他根本不看
Top-p 会把候选答案按概率从高到低排序,然后累加概率,直到达到设定的阈值
testfather.cn
假设 AI 生成下一个词的候选有
| 词语 | 概率 | 累计概率 |
|---|---|---|
| 天气 | 35% | 35% |
| 阳光 | 25% | 60% |
| 今天 | 20% | 80% |
| 很好 | 10% | 90% |
| 明媚 | 5% | 95% |
| 舒适 | 3% | 98% |
| 晴朗 | 2% | 100% |
- Top-p = 0.6:只考虑"天气"和"阳光"(累计到 60%)
- Top-p = 0.9:考虑前四个词(累计到 90%)
- Top-p = 1.0:考虑所有候选词
形象比喻:
大学招生不只看绝对排名(top-k),而是设定一个“最低录取分数线”:把所有申请学生按成绩(概率)从高到低排队,录取到累积分数(概率和)刚好超过分数线 p 为止的那批学生。然后在这批“合格学生”(一个动态变化大小的群体)中,按成绩比例随机录取一人。Top-p 就是设定这个分数线 p。
Top P 就像一个动态的门槛,这种方法动态地调整候选词汇数量,相比固定数量的选择更灵活:
-
p 小 (比如设为0.1、0.3): 只保留最头部的几个词、概率累积占整体很小一部分的词能进入候选池,输出非常保守。
-
p 大 (比如设为0.9、0.95): 允许更多可能性的词进入候选池,保留多样性,丰富性、同时切除极不靠谱的尾部。
技术本质:
- 模型计算出所有词的概率分布。
- 将这些词按概率从高到低排序。
- 计算排序后的累积概率和。
- 只保留累积概率和首次达到或超过 p 的那部分词。例如,p=0.92,那么保留的最小的那组词,其累积概率 ≥ 0.92。
- 将这些保留的词的原始概率重新归一化。
- 从这个新的归一化后的概率分布中随机抽取下一个词。
使用场景
-
p 在 0.7 - 0.95 之间比较常用。(0.9最常用)
-
p=0.9 或 0.92 通常是一个不错的起点,被认为在许多任务中提供了良好的多样性-质量平衡,适合需要长文本连贯性、创意写作、对话生成等强调整体质量和自然多样性的场景。
参数小结
Top-k (死板排名):只取前几名,Top-p (动态范围):取合格线的
“Top-p 比 top-k 更‘聪明’,它能根据当前上下文概率分布,动态调整候选池的大小,它不看固定名额,而是按‘分数段’招生(p 就是分数线)。不管高分学生有多少,只要加起来过线就算合格,然后按实力随机挑。这样模型就能在不同场景下灵活调整‘候选池’规模,避免 top-k 的‘刻板印象’,通常效果更好更稳定,是现在的主流选择。”
2.4 最佳实践
首先,说结论:Top-k 和 Top-p 一般不同时用!通常建议只选用其中一个来控制候选池的范围,top-p 通常是首选。
最常见的组合: Temperature + Top-p
例如:temperature=0.7, top_p=0.9,这是 OpenAI API 和许多现代大模型应用的默认或推荐设置。
一般只调整 temperature 或 top_p 其中一个,不要两个一起乱调。一般建议 temperature 保持默认0.7或1.0,可以先动 top_p,观察效果变化,效果稳定后再考虑叠加。从默认值附近小步调整,比一上来极端值(如 top_p=0.1)更稳。
合理配置 LLM 参数对于获得理想的生成效果至关重要,在实际应用中,我们需要根据具体任务需求来平衡创造性、准确性和性能。(temperature=0.7, top_p=0.9)在多数场景下都能提供良好的输出质量,这也是大多数场景下的默认配置。
上述这些参数的本质其实都是在做同一件事:在模型预测的下一个词的概率分布上动手脚,从而影响最终生成文本的特性。理解它们,能更好的掌握如何“驾驭”大模型的创造力。
需要注意,没有万能值! 不要试图寻找“完美通用参数”,根据场景来选择,不同模型、不同任务、不同提示词(Prompt)的最佳参数组合都不同,迭代实验是关键!
上述提到的这些模型参数可以通过
LangChain、LlamaIndex开发框架 或OpenAI Playground、WEB UI等可视化调试工具进行调整。
觉的有用,点个赞吧